

今回は、前回検証したLLaVA(Large Language and Vision Assistant)の日本語対応版であるLLaVA-JPを取り上げます。アイリアSDKに含まれているLLaVA-JPモデル(ailia-models/vision_language_model/llava-jp)を利用し、画像説明を行う手順とその動作を検証します。
LLaVAについては前回説明(https://interface.cqpub.co.jp/ailia018/)しましたが、今回扱うLLaVA-JPは、その日本語対応版であり、日本語での指示入力や日本語による説明生成に対応しています。これにより、日本語環境での利用が容易になり、教育/研究/開発の幅広い応用が期待できます。
実行環境
今回の検証で使用した環境を次に示します。
| 名称 | 内容 |
|---|---|
| OS | Ubuntu24 |
| CPU | Intel(R) Core(TM) Ultra 7 265K |
| RAM | 128MB |
| GPU | NVIDIA GrForce RTX 5060 16GB |
| Python | python-3.10.11-amd64 |
| ailia-SDK | Version 1.5.0.0 |
| ailia-models | v1.4.0 (https://github.com/axinc-ai/ailia-models) |
| cuda | Cuda compilation tools, release 13.0, V13.0.88 |
環境構築してLLAVA-JPを実行してみる
環境構築手順は、基本的にはailia-modelsリポジトリに含まれるREADME.mdの内容だけだと、正常終了することはできますが、ログにエラーが出力されます。これに対応するためには、追加でモジュールをインストールする必要があります。
pip install ‘tensorflow[and-cuda]’p初回実行時には、必要なモデル・ファイルがインターネットから自動的にダウンロードされます。そのため、インターネットに接続された環境でスクリプトを実行してください。なお、ダウンロードするファイルの合計サイズは、約7.2GBです。
環境を指定せずに実行した場合、デフォルトでenv_id: 1が選択され、CPU-IntelMKL環境で処理が行われます。次はその実行例です。
> python llava-jp.py
INFO arg_utils.py (13) : Start!
INFO arg_utils.py (163) : env_id: 1
INFO arg_utils.py (166) : CPU-IntelMKL
デフォルトの条件で参照される画像を図1に示します。
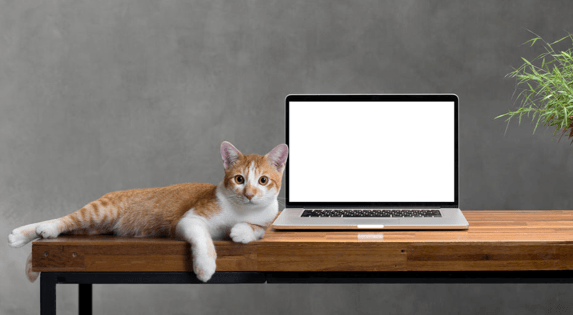
次にデフォルトのプロンプトは、
猫の隣には何がありますか?です。
このときの実行結果は表2のようになりました。
| 環境 | 生成した説明 |
|---|---|
| env_id: 1 | 猫の隣にはノートパソコンがあります。 |
任意の画像を入力して精度を検証
検証には新幹線の駅ホーム画像(図2)を用いました。駅のホームは、安全面や時刻の確認など注意すべき点が多く、生成される説明文の質を評価する題材として適しています。
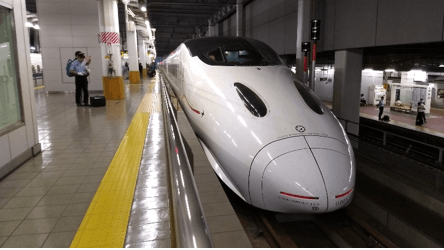
プロンプトは、
この場所を訪れる際に、注意すべきことは何ですか?です。
環境別に生成された説明文を表3に示します。
| 環境 | 生成した説明 |
|---|---|
| CPU env_id:0 | この場所を訪れる際には、安全を確保するためにいくつかの注意事項を守る必要があります。まず、列車が駅に停車している間は、ホームの端から安全な距離を保つ必要があります。これは、列車が完全に停止するまで待つことを意味します。次に、列車が完全に停止するまで辛抱強く待つことが重要です。これは、列車が完全に停止するまで待つことを意味します。さらに、ホームの端に立っている人や、列車の近くにいる人は、列車が近づいてきたら、安全な距離を保ち、列車が完全に停止するまで辛抱強く待つ必要があります。最後に、列車のドアが閉まっているか、列車が完全に停止していることを確認することで、乗客は列車が完全に停止するまで待つことができます |
| CPU-IntelMKL env_id:1 | この場所を訪れる際には、安全で快適な体験を保証するために、いくつかの注意事項を守る必要があります。まず、列車のホームにいる乗客は、ホームの端から安全な距離を保ち、列車のドアが完全に閉まっていることを確認してください。また、列車のドアが完全に閉まっていることを確認することで、乗客が誤ってドアを開けてしまうのを防ぐことができます。 さらに、列車のドアが完全に閉まっていることを確認することで、乗客は列車が完全に停止するまで辛抱強く待つことができます。また、ホームの端に立っている人は、列車が完全に停止するまで待ってから乗車するようにしてください。 最後に、乗客はホームの端から安全な距離を保ち、列車が完全に停止するまで辛抱強く待つことが重要です。これにより、乗客は列車が完全に停止するまで辛抱強く待つことができ、事故のリスクを最小限に抑えることができます。 |
| GPU,NVIDIA (FP32) env_id:2 | この場所を訪れる際には、安全で快適な体験を保証するために、いくつかの注意事項を守る必要があります。まず、列車のホームの端にある黄色い線のあるプラットフォームに立っている人がいるので、列車が完全に停止するまで辛抱強く待つ必要があります。次に、列車のドアが閉まっているか、列車が完全に停止していることを確認してください。さらに、ホームの端に立っている人は、列車が完全に停止するまで待ってから、ホームの端に近づき、列車のドアが完全に閉まっているか、列車が完全に停止しているかを確認する必要があります。最後に、ホームの端に立っている人は、列車が完全に停止するまで辛抱強く待つ必要があります。これらの注意事項に従うことで、乗客は事故や怪我のリスクを最小限に抑えながら、列車の到着を待つことができます。 |
| GPU,NVIDIA (FP16) env_id:3 | 電車 |
今回の検証から、実行環境の違いによって生成される説明文の特徴に差異が見られました。
CPU環境(env_id:0,1)
出力文は比較的長く、注意点を丁寧に列挙していました.ただし、同じフレーズや表現が繰り返される傾向があり、冗長さが目立ちました。特に「列車が完全に停止するまで待つ」といった表現が複数回登場し、生成の冗長性が課題として挙げられます。
GPU環境(env_id:2, FP32)
黄色い線への言及など、より具体的で実用的な注意点が加わりました。CPU環境に比べて冗長さが少なく、文章構造も整理されている印象を受けます。なお、先に検証したLLaVAの結果に比べると簡素な内容ですが、使用したモデル・サイズが約半分(7.2GB/14GB)であることを考慮すると、LLaVA-JPの出力としては妥当と考えられます。
GPU環境(env_id:3, FP16)
出力は「電車」の一語のみであり、極端に簡略化されました。推論の精度やモデル内部の表現力がFP16計算によって制約された可能性が考えられます。
総じて、CPU環境では詳細で冗長な説明、GPU環境(FP32)では具体性と簡潔さ、GPU環境(FP16)では表現力の大幅な低下が確認できました。
まとめ
今回は、日本語対応版LLaVA-JPを用いて画像説明文の生成を検証しました。その結果、LLaVA-JPは日本語での画像説明に対応可能である一方、実行環境によって生成結果の質が大きく変動することが確認できました。特にGPU環境(env_id:2, FP32)では、具体性のある説明が得られやすく実運用に適していると考えられます。従って、今後の利用にあたってはこのGPU環境を前提としつつ、運用シナリオに応じて入力画像やプロンプトを調整していくことが望まれます。
氏森 充(うじもり・たかし)氏
約30年間、株式会社構造計画研究所にてIoT、ビッグデータ、機械学習、AI関連のシステム開発や実務応用に従事。退職後はLLM(大規模言語モデル)関連の情報収集や技術動向の調査・発信に注力し、雑誌『Interface』でもLLM技術に関する記事を執筆中。
SHARE THIS ARTICLE